Видео с ютуба Kv Cache

How KV Cache Speeds Up LLMs for Faster AI Models on GPUs

The KV Cache: Memory Usage in Transformers
KV Cache - Explained

KV-кэш: трюк, который ускоряет LLM

Кэш ключ-значение: упрощение работы с большими языковыми моделями.

Дайте мне 20 минут, и вы навсегда поймете, как работает KV-кэш
Кэш KV за 15 мин
KV Cache Explained | LLM Inference System Design and GPU Memory
Объяснение кэша KV

[2026/04/29 Сем 11] KV Cache. Quantization (Александр Крапухин)

Inference Engineering Lecture 3: KV Cache, Prefill & Decode, GPU Architecture and TurboQuant

KV Cache Explained: Why Output Tokens Cost More Than Input

KV Cache: The Invisible Trick Behind Every LLM
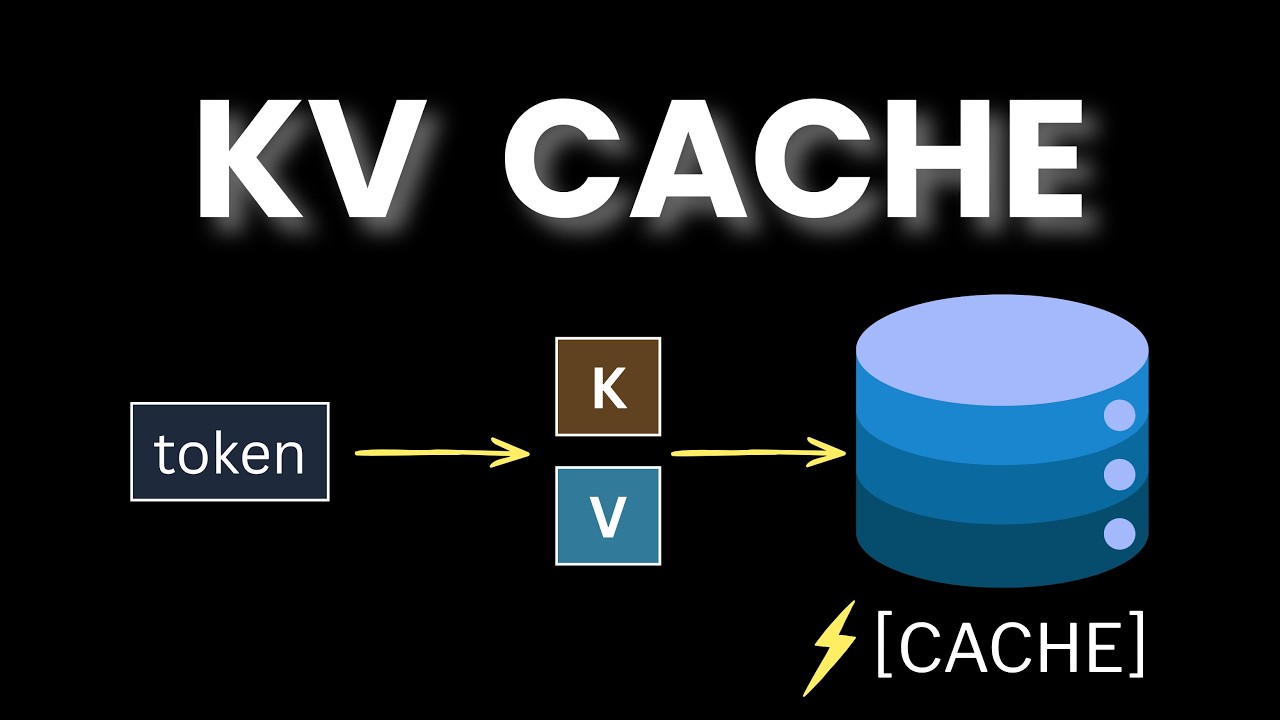
Визуальное объяснение работы KV-кэша в LLM-системах | Как LLM-системы быстрее генерируют токены
Нам больше не нужен KV-кэш?
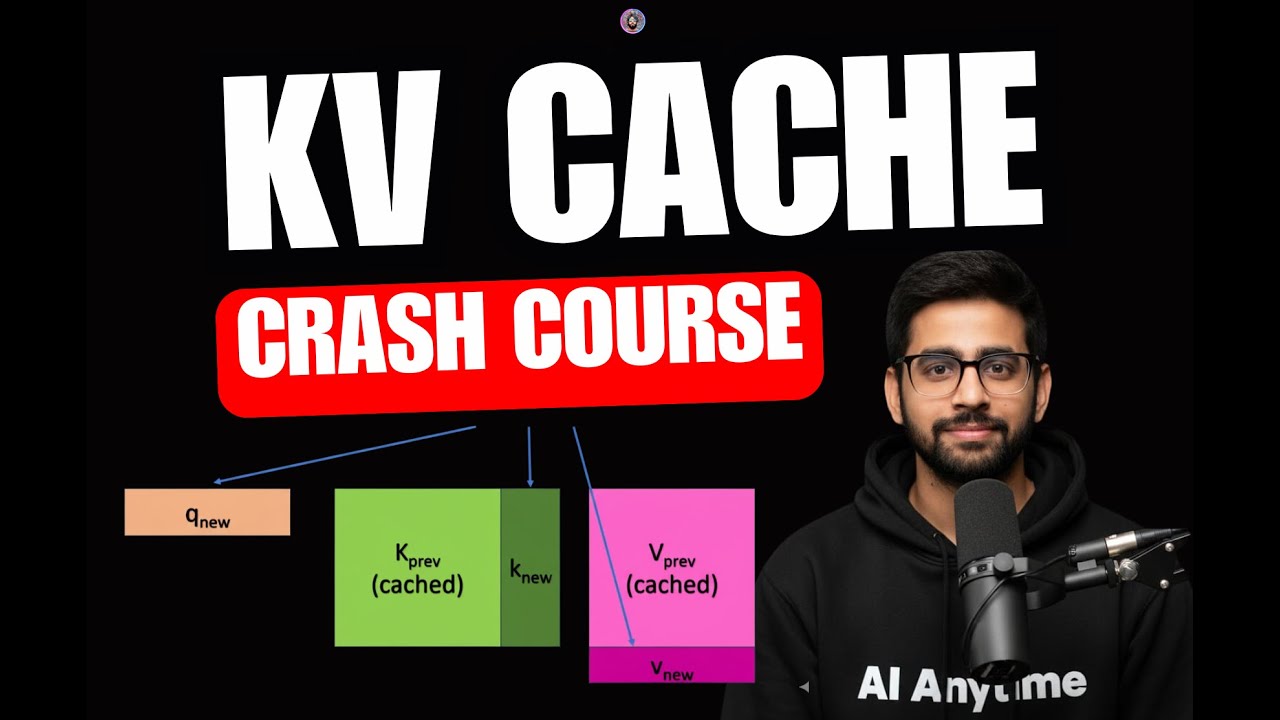
Экспресс-курс по KV-кэшу

Кэш ключ-значение в LLM-выводе — подробный технический анализ.
Key Value Cache from Scratch: The good side and the bad side
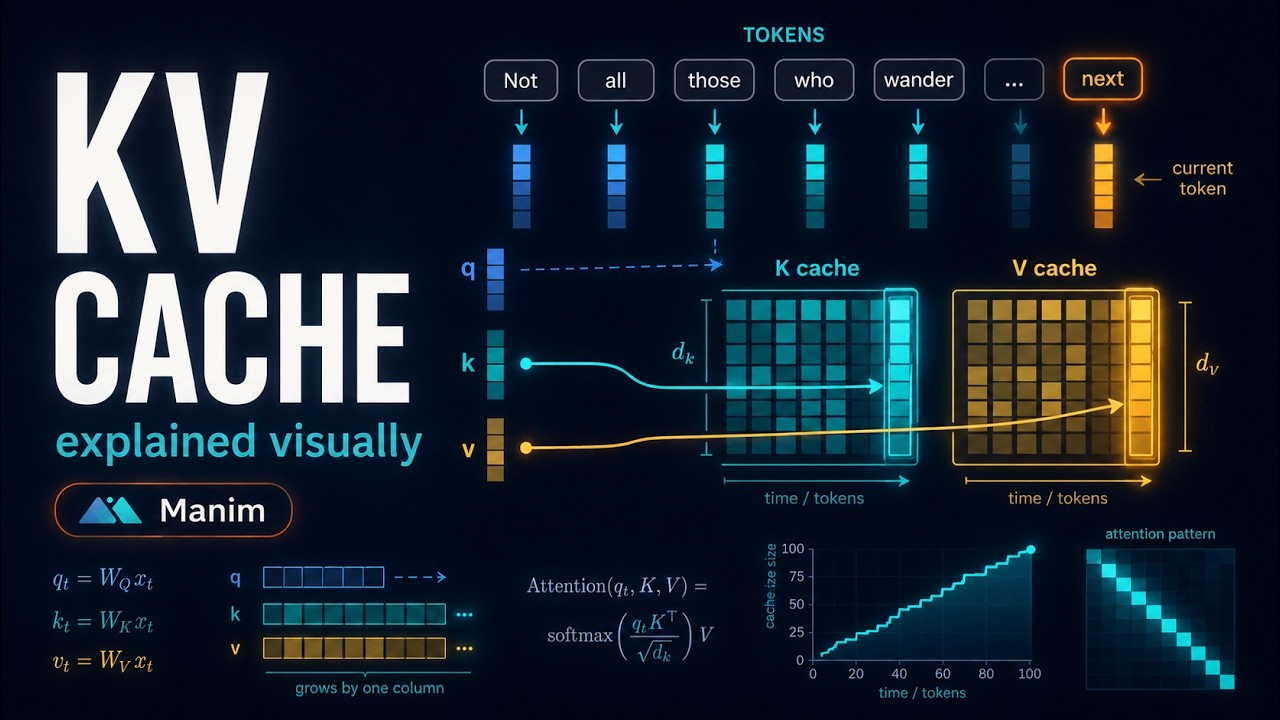
What is KV cache?

Объясняем LLaMA: KV-кэш, ротационное позиционное кодирование, RMS-нормализация, групповое внимани...